单个镜头最长 30 秒
每次生成 3 到 30 秒,以 1 秒为单位调整。一个连续镜头里,主体和场景从第一帧到最后一帧保持一致,足够讲完一个完整的小故事。

快手最新的视频模型,一次生成 3 到 30 秒的连续镜头,自带立体声、口型同步的对白,最高 1080p 分辨率。在 VideoAI 用关键帧和参考素材精准掌控每个画面。
这支 30 秒的球鞋广告由 Kling 4.0 一次生成:两位跑者、一双鞋、八个场景,外加配乐。点击下方节点即可跳到对应镜头。
输入:两张模特照片和三张产品图。输出:一条带配乐、连续不断的 30 秒视频。
Kling 3.0 最长 15 秒,Kling 4.0 可生成 3 到 30 秒,以 1 秒为单位调整,完整的故事不用再拼接。
即使镜头切换多个场景,人物、产品和环境在每一个镜头里都保持一致。
在提示词里写清时间,比如“0–5 秒特写,5–12 秒跟拍”,模型会按这个节奏安排镜头。
更长的镜头、真实的声音、更精细的掌控。打开声音,听听每段视频的效果。
每次生成 3 到 30 秒,以 1 秒为单位调整。一个连续镜头里,主体和场景从第一帧到最后一帧保持一致,足够讲完一个完整的小故事。
对白、歌声、音效和环境音与画面一起生成,输出双声道立体声,说话和唱歌时的口型都能对上。
最多可组合 10 张图片、5 段视频(总长 30 秒)、7 个主体和音色参考。告诉 Kling 4.0 每个参考负责什么,从人物长相到运镜都能指定。
上传视频里必须出现的画面,比如某个姿势、一次转场或一个揭晓瞬间。可以只用首帧、用首尾帧,或者最多 10 个关键帧,故事会按顺序依次经过。
对上传的视频修改表情、动作、机位、背景或整体风格。每次编辑最多 5 段视频、总长 30 秒,没改动的部分保持原样。
角色可以说中文、英语、日语、韩语、西班牙语、葡萄牙语、德语、法语等语言,还支持各种口音和方言。镜头移动时,文字、表情符号和 Logo 依然清晰。
每个案例都附上了它用到的输入素材,以及一段可以直接改着用的提示词。
一张八格分镜图画的是屋顶梅花桩上的舞狮,生成后变成一个连续的动态镜头,依次经过每一格画面。
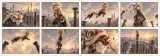
@Image1 是一张八格分镜图。把它做成一个连续镜头,按顺序经过每一格:日落时分,舞狮队在城市上空的高桩之间腾跃。锣鼓声和人群欢呼声。
一张黏土宇航员小狗的三视图,加上一张逐格分镜,生成了一段在奶酪月球上追逐的定格动画。
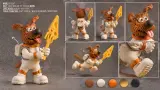
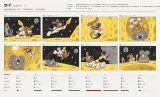
@Image1 定义了黏土宇航员小狗,每个镜头都要保持它的造型。按 @Image2 的分镜逐格推进。定格黏土动画风格,在奶酪做的月球上追逐,配上轻快的音乐。
一张拼贴风海报被做成品牌短片:纸片层层错动,地球转动,标题一个字母一个字母重新拼出来。
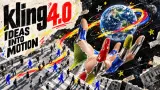
把 @Image1 做成一支 14 秒的品牌短片。撕纸层向两边滑开,地球转动,彩绘的手朝镜头张开,标题文字逐个字母拼合。保留拼贴质感和配色。轻快的音乐。
取一段视频的跟拍运镜,加上一张角色三视图和一条空走廊,合成一段全新的追逐镜头。
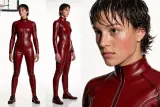
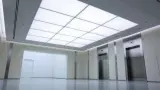
参考 @Video1 的运镜。@Image1 中的女人沿着 @Image2 里的白色走廊奔跑,镜头紧跟在她身后。
用三个角度定义的黏土小猪被加进一段古装剧片段里,原有的对白照常进行。
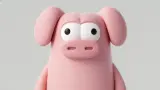
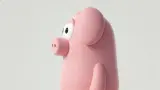
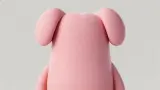
把 @Image1、@Image2 和 @Image3 中的黏土小猪加到 @Video1 里,站在壁炉边的人群中间。场景、对白和镜头都保持原样不变。
喷泉边乐队演出画面里的路人被去掉,只留下乐手和广场。
去掉 @Video1 里的路人,只保留乐队和喷泉广场。音乐和运镜保持不变。
只给一句提示词,Kling 4.0 就补全了人物、布景、运镜和表演,说话的声音也在同一次生成里完成。
一位老人在吐槽 AI。
黄昏的英国街头,一段手持拍摄的重逢。脚步声、街道环境音、音乐和英语对白都写在了提示词里。
一个连续 7 秒的手持镜头,黄昏时分英国一条安静的街角。两个多年未见的老朋友认出彼此,快步走近拥抱,路人从身边经过。表情自然,镜头轻微晃动,温暖怀旧的光线。音频:脚步声、街道环境音、轻柔的音乐,其中一人用英语说 "I can't believe it's you."
Kling 4.0 时长翻倍,新增关键帧和立体声,可用的参考素材也多了很多。
| 参数 | Kling 4.0 | Kling 3.0 |
|---|---|---|
| 单次生成时长 | 3–30 秒 | 3–15 秒 |
| 画面控制 | 首尾帧,最多 10 个关键帧 | 首尾帧 |
| 参考素材 | 最多 15 个:10 张图片、5 段视频(共 30 秒)、7 个主体、音色 | 最多 7 张图片/主体,或 1 段视频(15 秒)+ 4 张图片 |
| 音频 | 双声道立体声,口型同步 | 单声道 |
| 对白语言 | 中文、英语、日语、韩语、西班牙语、葡萄牙语、德语、法语等 | 中文、英语、日语、韩语、西班牙语 |
| 分辨率 | 720p / 1080p | 720p / 1080p |
| 动态范围 | 1080p 支持 10-bit HDR(即将上线) | 8-bit SDR |
| 画面比例 | 21:9、16:9、1:1、9:16、自动 | 不支持 21:9 |
| 提示词长度 | 最多 8,000 tokens | — |
参数来自可灵 AI 发布的 Kling 4.0 更新说明和使用指南。VideoAI 上可用的选项可能有所不同。
Kling 4.0 最擅长执行具体、带时间点的指令。三个步骤,再加一套可以反复套用的提示词结构。
打开 VideoAI 视频创作页,选择 Kling 4.0,上传需要的图片、视频或音色样本。它们会按上传顺序编号:@Image1、@Image2、@Video1。
说明每个素材负责什么,比如“@Image1:保留她的长相和服装”,或“@Video1:照搬这段运镜”。没有分配任务的参考,生成结果会更难预料。
带上时间点逐段描述画面,写明想要的声音,选择 3 到 30 秒的时长和画面比例,然后点击生成。
Kling 4.0(可灵 4.0)是快手旗下可灵 AI 推出的最新视频模型。它可以根据文字、图片或最多 15 个混合参考,一次生成 3 到 30 秒的视频,自带双声道立体声和口型同步的对白,支持最多 10 个关键帧,分辨率最高 1080p,还能编辑你上传的视频。
每次生成 3 到 30 秒,以 1 秒为单位调整,默认 10 秒。这是 Kling 3.0 最长 15 秒的两倍。
能。对白、歌声、音效和环境音会与画面一起生成,输出双声道立体声,口型也会和台词对上。如果不需要背景音乐或字幕,在提示词里说明即可。
Kling 4.0 支持 720p 和 1080p,画面比例有 21:9、16:9、1:1、9:16 和自动。可灵 AI 已宣布 1080p 的 10-bit HDR 输出即将上线。
每次生成最多 15 个:最多 10 张图片、5 段总长 30 秒的视频、7 个主体(其中最多 3 个由视频创建)以及音色参考。在提示词里用 @Image1、@Video1 这样的编号指代每个素材,并说明它负责控制什么。
关键帧是视频中必须出现的画面,比如某个姿势、一次转场或一个揭晓瞬间。你可以只设首帧,也可以设首尾帧,或者最多 10 个关键帧,Kling 4.0 会按顺序依次经过它们。
中文、英语、日语、韩语、西班牙语、葡萄牙语、德语、法语等。还可以指定口音,比如美式、英式或印度英语,以及粤语、四川话、北京口音等中文方言。把台词放在引号里,并在提示词里写明口音。
能。上传一段主视频,再加最多 4 段视频作为参考(每段 3 到 30 秒,总长 30 秒),然后描述想改的地方。Kling 4.0 可以替换角色或背景、去掉某个物体,或修改动作、机位和风格,镜头的其余部分保持不变。
把 Kling 4.0 和 VideoAI 上的其他视频、图片模型比一比。